


成直PHM系統在產線工控機運維中的應用
0 引言
在工業自動化產線中,工控機通常作為上位機承擔設備控制、數據采集與組態顯示等任務,處于承上啟下的位置。與電機、變頻器、可編程控制器等被控設備相比,工控機自身的健康狀態往往不在監測范圍內,其維護主要依靠人工巡檢和故障后搶修。
現場情況表明,工控機的多數故障并非完全突發。CPU 散熱能力下降會使溫度在數月內緩慢上升;上位機程序長期運行會造成內存占用逐班次增長;磁盤 SMART 信息中的重映射扇區數、待映射扇區數往往在盤體徹底失效前先行增長;內存不足時頁錯誤次數長期偏高。這些征兆在故障發生前就已存在,只是缺少連續采集與分析手段,難以及時發現。
本文介紹成直 PHM 系統在某電子制造企業產線的應用情況,說明其現場問題、監測對象界定、系統構成、數據采集實現、預警機制及運行效果。
1 現場問題與監測對象
1.1 現場存在的問題
該企業產線原采用人工定期巡檢方式維護上位機,主要存在以下問題:
(1)故障多為突發暴露。上位機在高溫季節出現散熱不良死機、內存耗盡卡死、磁盤損壞等情況,發現時已造成停機。
(2)缺少趨勢數據。人工巡檢只記錄當前狀態,無法判斷溫度、內存占用等指標的長期變化趨勢,難以提前干預。
(3)故障定位困難。上位機死機后缺少故障前的狀態記錄,排查主要依靠經驗判斷。
(4)維保過程缺少記錄。更換硬盤、清理散熱等操作未形成工單,備件與責任追溯困難。
1.2 監測對象與邊界
本系統的監測對象是工控機這一計算節點本身,不包括電機、減速機、主軸等被控設備。系統不采集振動、電流、轉速信號,也不通過 PLC 讀取設備運行數據。這一界定基于現場分工的考慮:被控設備的機械狀態已有振動監測等手段覆蓋,而工控機自身的硬件健康狀態尚缺乏對應的監測手段,屬于運維盲區。
2 系統構成
系統由四個可執行模塊組成,總體構成如圖 1 所示。
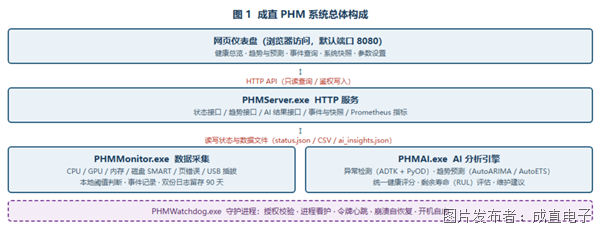
圖 1 成直 PHM 系統總體構成
各模塊功能如下:
(1)PHMWatchdog 守護進程:負責授權校驗、進程看護、令牌心跳與崩潰自恢復。任一模塊異常退出后,由其在 1 分鐘內重新拉起;系統隨操作系統啟動自動運行。
(2)PHMMonitor 采集程序:按設定周期采集各硬件指標,執行本地閾值判斷并記錄事件。
(3)PHMServer HTTP 服務:對外提供狀態、趨勢、AI 結果、事件與快照等接口,默認監聽 8080 端口。
(4)PHMAI AI 引擎:讀取采集數據,完成異常檢測、趨勢預測、剩余壽命評估與維護建議生成。
模塊之間以文件為媒介傳遞數據:采集程序寫入 CSV 與狀態文件,AI 引擎讀取 CSV 并輸出分析結果,HTTP 服務讀取上述文件后對外提供接口,網頁儀表盤通過接口獲取數據并渲染。采用文件解耦的方式,使各模塊可獨立升級,也便于故障時單獨重啟。
3 數據采集實現
3.1 采集指標
系統采集的指標如表 1 所示。
表 1 采集指標一覽
類別 | 采集內容 | 采集周期 |
CPU | 溫度、負載、功耗、電壓、頻率 | 15 秒 |
GPU | 溫度、負載、風扇、功耗、顯存 | 15 秒 |
內存 | 使用率、已用容量、頁錯誤次數 | 15 秒 |
磁盤 | 溫度、SMART(重映射/待映射/不可糾正扇區、磨損、健康分)、讀寫速率 | 15 秒 |
系統 | USB 插拔事件、WHEA 與系統錯誤計數 | 1 秒 / 15 秒 |
3.2 采集接口與回退機制
系統不依賴外接傳感器,而是通過操作系統與硬件的標準接口獲取數據。以 CPU 溫度為例,采集按四層順序回退,流程如圖 2 所示:優先讀取主板 MSR 寄存器;失敗則讀取 PDH 性能計數器;再失敗則查詢 WMI 的主板 ACPI 熱區;最后調用硬件傳感器程序讀取。每一層成功即返回結果并標注數據來源,四層全部失敗時將該指標標記為不可用,界面顯示“--”,不影響其余指標采集。
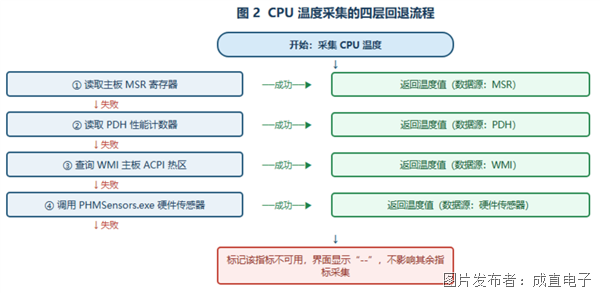
圖 2 CPU 溫度采集的四層回退流程
該設計使系統不依賴特定型號的主板或傳感器芯片,普通工控機與組裝機均可運行,差別僅在于可采集指標的多少。對于現場大量存在的非品牌工控機,回退機制保證了系統的可用性。GPU 溫度通過 nvidia-smi 讀取,不可用時同樣回退;磁盤 SMART 信息通過 WMI 獲取。
3.3 本地處理與數據留存
異常判斷在工控機本地完成,數據不必全量上傳。這樣處理有兩個好處:一是外網中斷時本地監測與告警不受影響;二是原始數據不必全部傳輸,節省帶寬。
采集數據按日期分文件保存,主數據文件包含 53 列、中文表頭并帶 BOM,可直接用電子表格軟件打開;同時在運行目錄和日志目錄各保存一份,默認留存 90 天,超期自動清理。磁盤日志、退化日志與預測歸檔分別按分鐘、十分鐘與小時粒度記錄。
4 AI 分析與預警
4.1 統一健康評分
系統采用統一的百分制健康評分,由統計檢測扣分、硬故障扣分和致命項封頂共同決定。評分分為優秀(≥90)、良好(≥75)、警告(≥60)、退化(≥40)、危險(<40)五個等級,每條扣分均給出原因。當 AI 引擎暫時不可用時,系統回退為內置扣分方式,保證評分不中斷。
4.2 趨勢預測與剩余壽命
AI 引擎對采集序列進行異常檢測,并基于歷史數據給出未來 1 小時、4 小時、24 小時的預測值以及 7 天的日級趨勢;同時根據退化日志計算關鍵指標的變化速率,估算其達到告警限值所需時間,即剩余壽命(RUL),并給出風險等級。
4.3 數據不足時的處理
趨勢預測需要一定長度的歷史數據。系統在數據不足時保留空白而不輸出推測值:投產初期約一到兩個月以狀態監測為主;退化日志不足 7 天時,剩余壽命顯示為“數據積累中”。該策略避免了在樣本不足時給出誤導性結論。
5 告警與維保閉環
5.1 告警防誤報機制
系統告警采用三項措施抑制誤報:
(1)持續時長門控:指標超過閾值并持續一定時間后才觸發告警,濾除瞬時波動。
(2)遞增冷卻:同類告警觸發后,冷卻時間由 5 分鐘逐級延長至 2 小時;確需升級時可通過特定標志繞過冷卻。
(3)合并通知:告警在環形緩沖區中合并后統一推送至桌面通知與事件頁面,避免逐條彈出。
5.2 維保工單閉環
告警觸發后可生成維保工單,記錄指派人員、備件更換與檢修結果,使“發現異常”到“完成維修”的過程可追溯。這一環節使系統區別于僅提供報警的單點監測工具。
6 應用效果
6.1 部署情況
系統部署于該企業產線的上位機,采用安裝程序方式部署,隨操作系統啟動自動運行。部署前使用配套體檢工具檢查運行環境,確認無錯誤項后投入運行。系統運行界面如圖 3 所示。
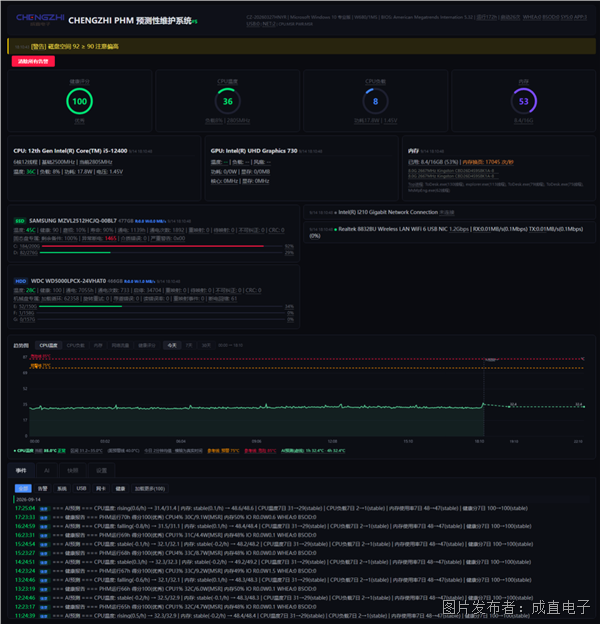
圖 3 系統總覽界面
6.2 運行數據
系統投運后連續運行,主要運行數據如表 2 所示。
表 2 投運后主要運行指標(示例)
指標 | 數值 |
綜合健康評分 | 100(優秀) |
CPU 溫度 / 負載 / 功耗 | 36 ℃ / 13 % / 22.4 W |
內存使用率 | 50.7 %(8.0 GB / 16 GB) |
固態盤(SSD) | 溫度 45 ℃,健康分 90,磨損 10 %,通電 11331 小時 |
機械盤(HDD) | 溫度 28 ℃,健康分 100 |
磁盤空間 | 使用率 92 %,觸發閾值告警(閾值 90 %) |
AI 分析結果與告警事件分別如圖 4、圖 5 所示。
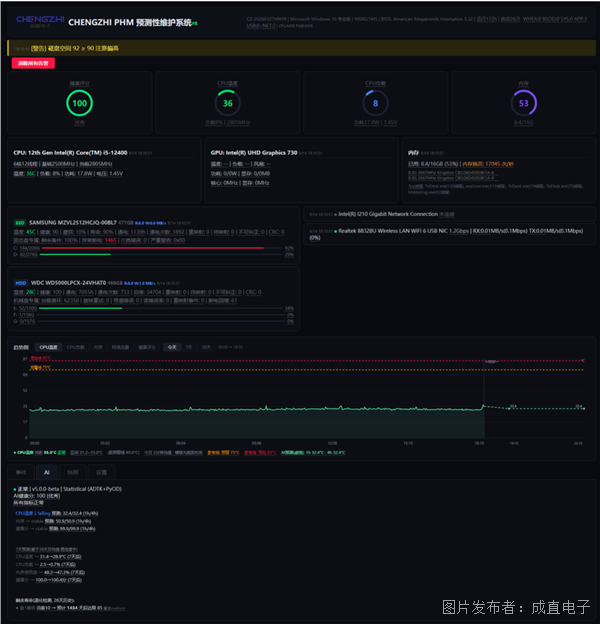
圖 4 AI 分析與預測界面
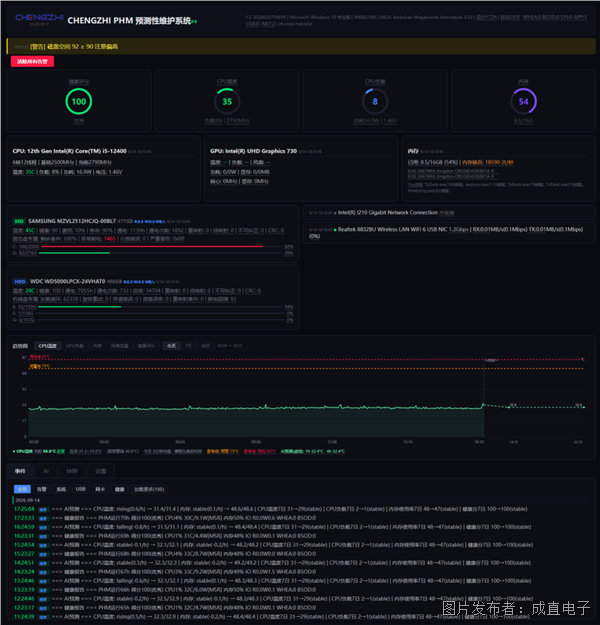
圖 5 告警事件與健康報告界面
6.3 效果分析
(1)連續監測替代人工巡檢。系統以 15 秒周期采集硬件狀態,覆蓋人工巡檢難以持續觀察的溫度、SMART 等指標。
(2)趨勢數據支持提前干預。以固態盤為例,其磨損度與健康分的變化趨勢可用于估算剩余可用時間,為備件準備提供依據。
(3)預警鏈路得到驗證。運行期間系統根據 92 % 的磁盤占用率觸發“注意偏高”告警,提示清理日志文件,處置過程中未影響生產。
(4)維保過程可追溯。告警與工單關聯記錄,更換備件與檢修結果可事后查詢。
7 結論
本文介紹了面向工控機主機的預測性維護系統在某電子制造企業產線的應用。系統通過系統級接口采集 CPU、GPU、內存、磁盤 SMART 等硬件狀態,在本地完成異常判斷,結合趨勢預測與剩余壽命評估生成分級告警與維保工單。現場運行表明,該方案能夠覆蓋人工巡檢難以持續觀察的指標,為工控機的維護提供數據支持,適用于將工控機作為關鍵上位機的產線場景。
需要說明的是,本系統的適用范圍限于工控機主機本身。被控設備的機械狀態監測、預測模型精度提升所需的故障樣本積累,以及現場運維制度的配合,仍是系統發揮作用的前提條件。
參考文獻
[1] ISO 13374-1:2003, Condition monitoring and diagnostics of machines — Data processing, communication and presentation — Part 1: General guidelines.
[2] ISO 17359:2018, Condition monitoring and diagnostics of machines — General guidelines.
[3] INCITS T13. AT Attachment 8 — ATA/ATAPI Command Set (ATA8-ACS), 2008.


 投訴建議

提交
